随着大语言模型的爆发式增长,AI的智力水平和结构演变引起了广泛讨论。很多人在惊叹模型强大能力的同时,常常会产生一个疑问:GPT-4 中有多少个神经元?为了科学地评估人工智能的发展阶段,行业内经常进行GPT-4参数量与人脑对比。然而,简单地将大模型的参数等同于人类大脑的脑细胞往往会带来认知误区。我们需要理清人工神经网络与生物神经网络区别,才能真正看清大模型与人类大脑的真实差距。
GPT-4 到底有多少个神经元?解析GPT-4参数量与人脑对比的换算误区
GPT-4 的混合专家架构与 1.8 万亿参数估算
探讨模型的底层结构时,我们必须先理解它的核心架构——混合专家架构。在早期阶段,人工智能模型大多是单体结构,即无论你输入什么问题,模型中的所有参数都会参与计算。但随着模型体量呈指数级增长,这种做法对算力的消耗是无法承受的。
因此,开发团队在GPT-4中采用了先进的混合专家架构。简单来说,它内部并不是一个单一的超级大脑,而是由16个专家组合而成的智囊团。每个专家大体上是一个独立的小型神经网络,各自拥有约1110亿个参数。当用户输入一个问题时,负责分发的门控网络会进行实时评估,并将任务分配给最合适的2个专家进行处理。
通过这种方式,模型的总参数量达到了惊人的1.8万亿,而在处理单个词元时,实际被激活运行的激活参数仅为约2800亿。这种高度灵活的架构设计,既保证了模型能够容纳海量的知识,又在实际运行中大幅度降低了大语言模型参数算力需求。
| 结构维度 | 核心数据描述 | 在计算中的实际作用 |
|---|---|---|
| 总参数量 | 约 1.8 万亿 | 模型存储的全部静态知识总量,也是AI能力储备的上限 |
| 激活参数量 | 约 2800 亿 | 每次回答问题时,真正动用的算力资源 |
| 专家数量 | 16 个独立专家模型 | 分工合作,分别擅长代码、逻辑、文学等不同专业领域 |
人工神经网络中的数学神经元与参数究竟怎么理解?
在厘清了1.8万亿参数后,我们再来回答GPT-4 中有多少个神经元这一核心问题。在计算机科学中,人工神经网络中的神经元与生物学上的神经元完全是两个层面的概念。
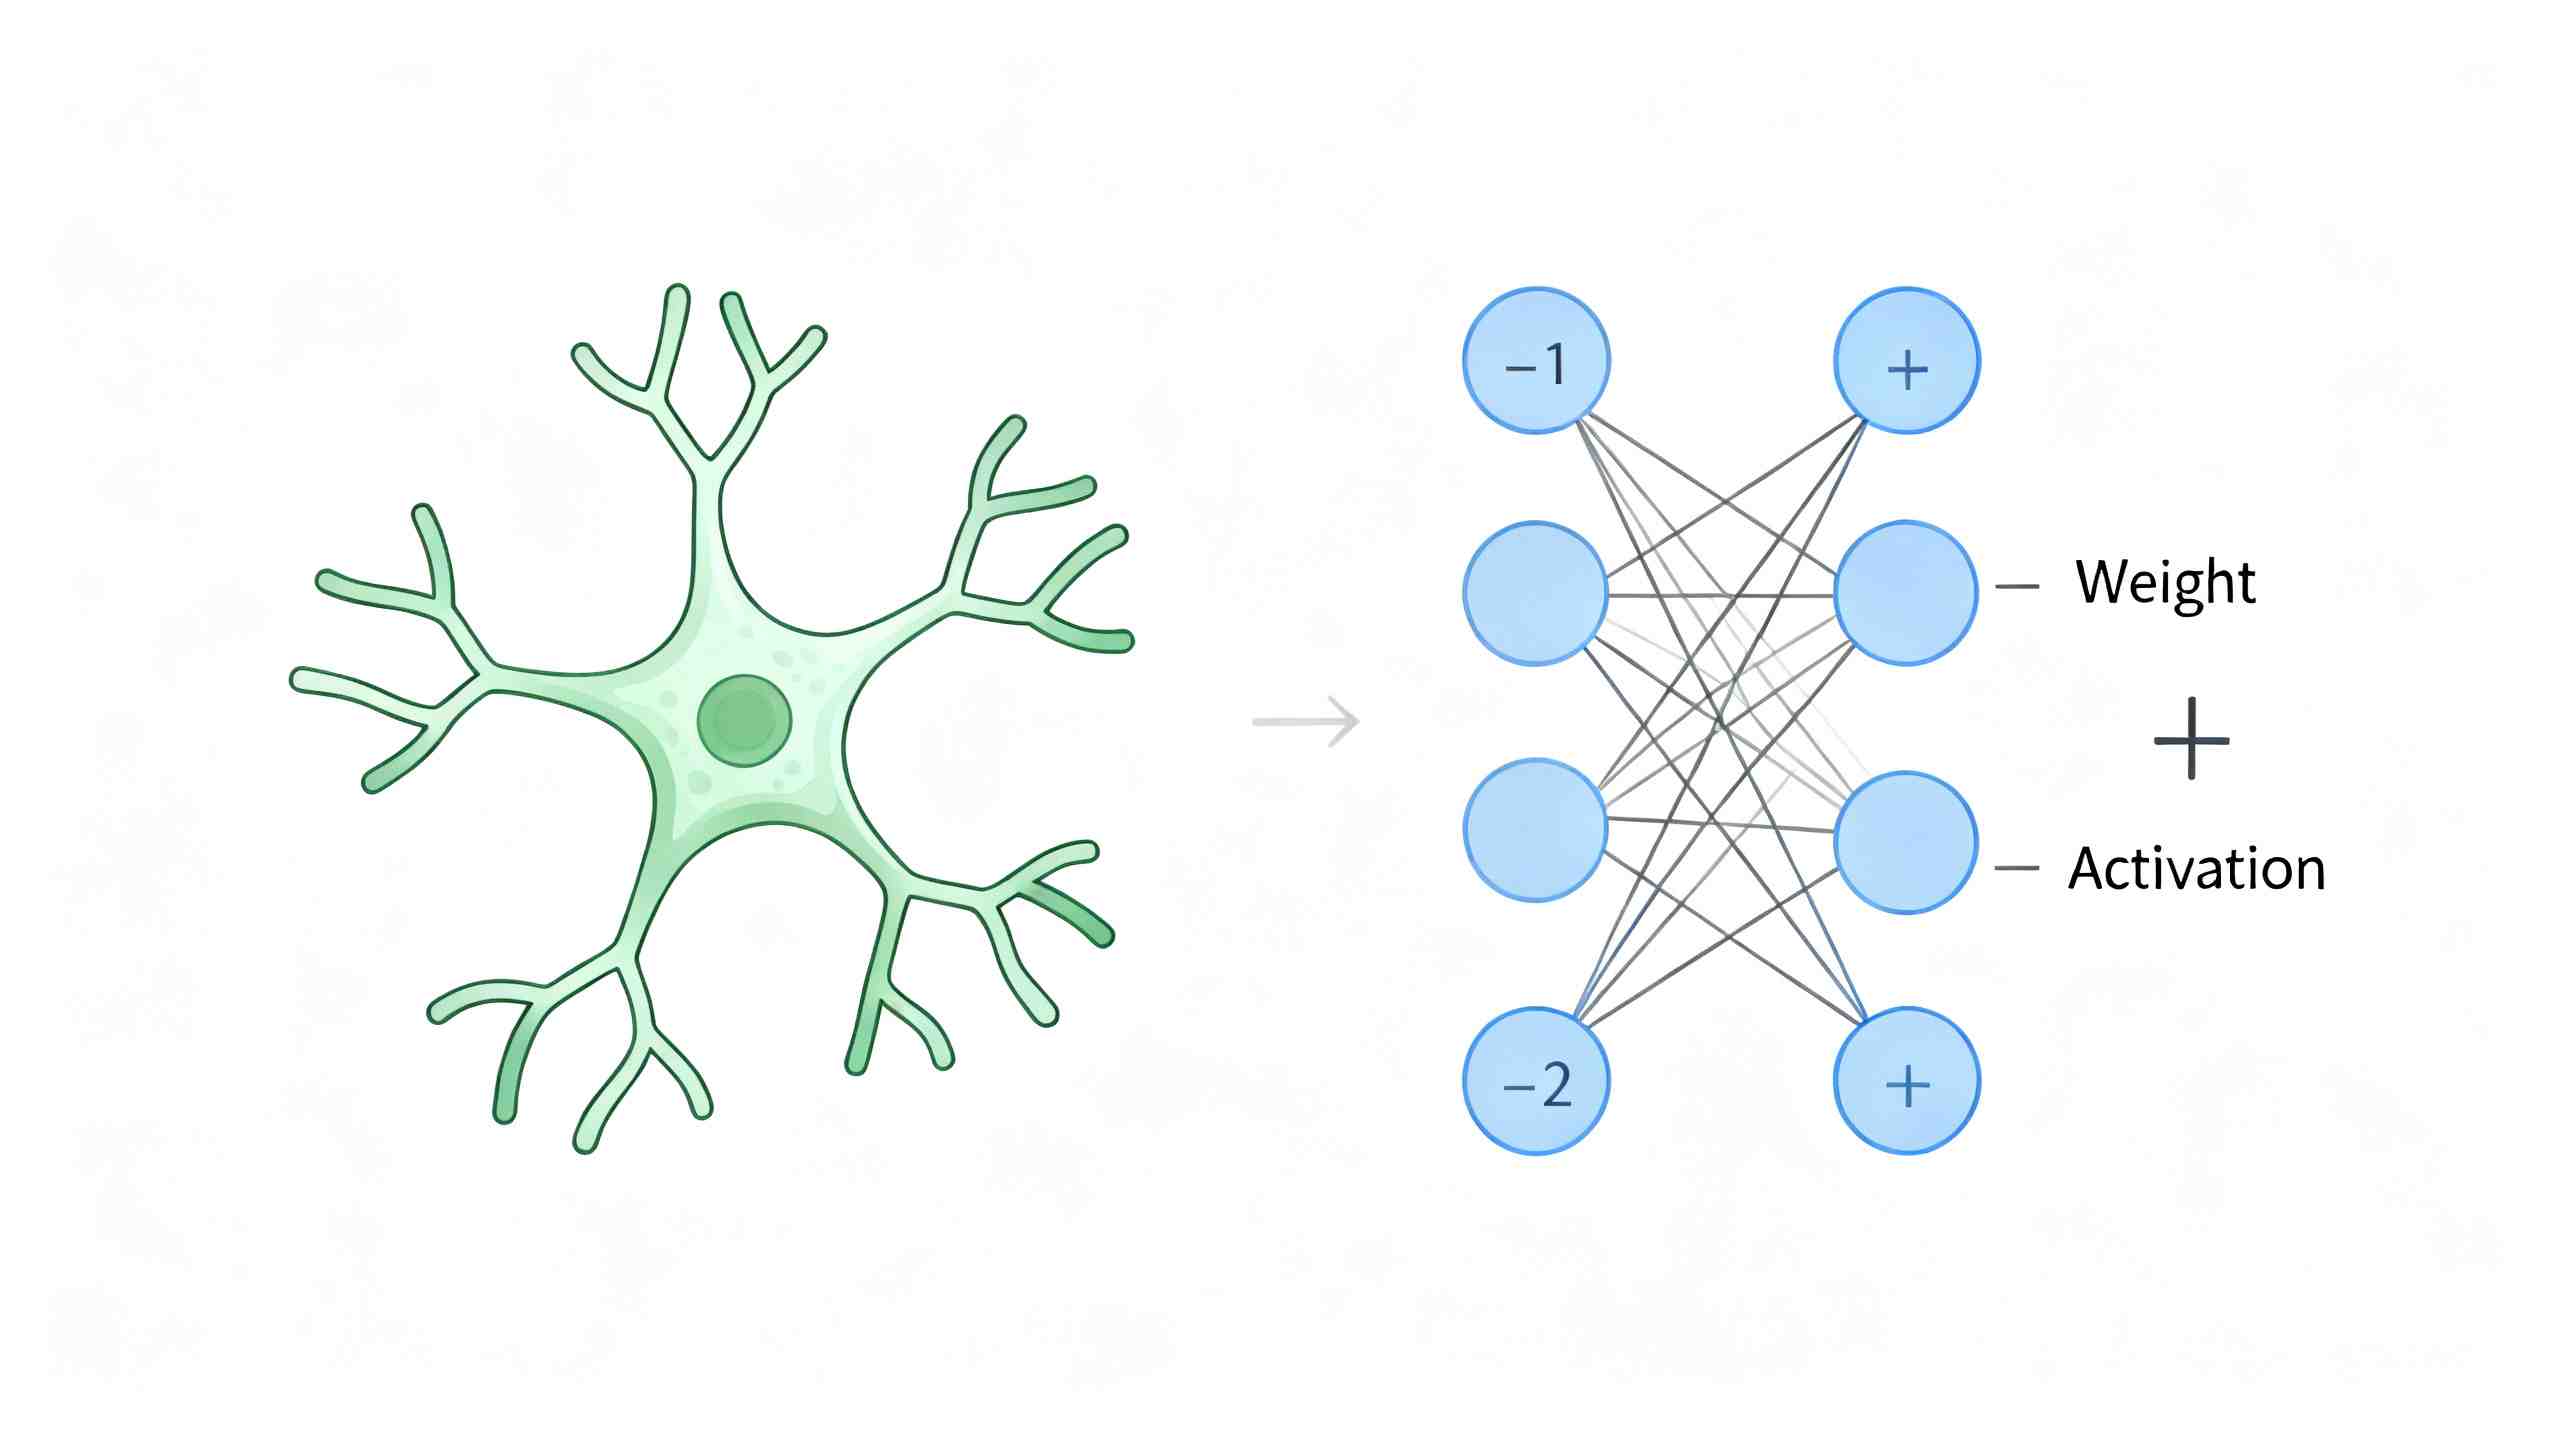
人工神经网络中的神经元实际上是一个数学节点。简单来说,它就是一个负责做乘加法运算并进行非线性转换的数学函数。在这个公式中,输入信号乘上权重,再加上偏置,通过激活函数输出。而这些权重和偏置就是大模型中的参数。接受 these 参数并输出结果的整个计算单元,才被称为一个人工神经元。
因此,我们可以得出一个极其重要的结论:参数并不等于神经元,参数是神经元之间的连接纽带。一个人工神经元可以拥有数千甚至数万个输入连接,这意味着每一个神经元周围都围绕着成千上万个参数。根据模型架构的配置估算,在GPT-4的每个专家内部,中间前馈网络层包含的数学神经元数量大约在千万级别,16个专家相加,整个模型的数学神经元总量在2亿到3亿个左右。而支撑这2亿多神经元的,是高达1.8万亿的参数连接。
算力与脑力的对决:人工神经网络与生物神经网络区别在哪里
人类大脑的 1000 亿神经元与大模型参数的本质区别
既然模型拥有约2亿个数学神经元 and 1.8万亿个参数,那么将它进行GPT-4参数量与人脑对比时,结果如何呢?
根据神经科学的测定,人类大脑包含约 860 亿到 1000 亿个生物神经元。这在数量上就已经比大模型的数学神经元多出了数百倍。更重要的是,生物神经元之间的连接极其旁杂,一个生物神经元可以通过树突和轴突与多达一万个其他神经元相连,在人脑中织就了一张拥有 100 万亿个突触的超大规模网络。如果我们把大模型的参数对应人类大脑的突触,那么人脑的容量大约是模型的50多倍。
除了数量上的悬殊之外,我们更应该关注人工神经网络与生物神经网络区别的本质。生物神经元并不是冰冷的数学开关,每一个生物神经元都是一个极其复杂的化学工厂,能够动态合成和释放数十种神经递质。这种机制使得人脑具有高度的可塑性——当你学习新知识时,你的突触物理结构会在几毫秒内发生改变。而大模型的参数在训练完成后就已经固化在显存中,在不重新微调的情况下是无法自我进化的。
| 对比维度 | 人类大脑 (生物神经网络) | GPT-4 (人工神经网络) |
|---|---|---|
| 基础计算单元 | 约 1000 亿个高度复杂的生物活体细胞 | 约 2 亿至 3 亿个静态数学计算节点 |
| 连接规模(突触 vs 参数) | 约 100 万亿个电化学突触通道 | 约 1.8 万亿个浮点数权重参数 |
| 能量消耗 | 仅约 20 瓦特(相当于一个低功率灯泡) | 需要数兆瓦特以上的芯片集群电力支持 |
| 信号传输介质 | 混合模拟与数字的电化学信号 | 计算机高精度的二进制浮点数运算 |
| 实时学习能力 | 支持,拥有瞬时的突触物理重构能力 | 不支持,必须通过算法进行离线训练 |
OpenAI 如何利用 GPT-4 自动解释 GPT-2 中 30 万个神经元激活行为
尽管人工神经元在结构上比生物神经元简单得多,但当成千上万个数学神经元组合在一起时,大模型内部的计算逻辑也会变得如同黑盒般难以琢磨。为了解决这一痛点,开发团队在可解释性人工智能领域展开了开创性的研究。
在一项学术论文中,研究人员尝试使用更先进的GPT-4模型,去自动解释较小模型GPT-2中全部30万个神经元的激活行为。这项研究展示了人工智能在自我剖析方面的巨大潜力。
具体的研究过程如下:
- 观测激活: 首先,研究人员向模型输入大量文本,记录某个特定神经元在什么词汇或语境下会产生强烈的激活信号。
- 生成解释: 随后,研究人员将这些高激活状态的文本片段提供给高级模型,让其分析规律并用人类的语言写出解释(例如:“这个神经元会在遇到与特定英雄角色相关的词汇时激活”)。
- 模拟验证: 最后,模型会基于自己生成的这套解释,去模拟预测目标神经元在面对新文本时的表现,从而评估这条解释的准确度。
这一研究虽然刚刚起步,但它为人类窥探大模型内部的思维火花提供了一条可行的路径。如果您对这一前沿学术成果感兴趣,建议深入阅读 OpenAI关于语言模型解释神经元的官方研究论文。
常见问题解答:关于 GPT-4 中有多少个神经元的疑问
GPT-4一共有多少个参数?它等于神经元吗?
模型的总参数量约为1.8万亿,但参数并不等于神经元。参数相当于神经元之间连接的粗细或强度(类似于人类大脑中的突触),而数学神经元则是网络中的计算节点。该模型的神经元数量在数亿级别,而每一个神经元周围都连接着成千上万个参数权重。
为什么不能直接把大模型的参数等同于人类大脑的突触?
因为两者的复杂度和性质有着本质差异。人类大脑的100万亿个突触不仅是信号通道,更是动态变化的活体化学结构。一个突触内部的计算潜能甚至可能相当于一个微型神经网络。而算法模型中的参数只是计算机显存里存储的静态数字,并不具备生物突触高度的化学可塑性和自主生长能力。
使用高级模型去解释低级模型的神经元有什么实际意义?
这是为了解决黑盒问题所做的一项可解释性研究。由于我们很难直接理解数十亿甚至数万亿参数大模型是如何思考的,利用更高级的算法作为观察者,去自动剖析较小模型中数十万个数学神经元的激活规律,并用人类看得懂的语言解释它们都在负责处理什么信息,这有助于推动人工智能安全和可控性的发展。
在计算效率和能耗上,硅基AI大模型何时能赶上人脑?
目前来看依然有极大差距。目前的算力集群运行一次可能需要消耗几百万瓦的电量,而人类大脑只需要约20瓦就能完成复杂的逻辑推理。这种低能耗和高效率源自生物神经网络的脉冲传输和稀稀激活特性。未来硅基设备若要比肩人脑,可能需要依赖类脑计算芯片或全新的计算范式架构。
总结:从大语言模型参数看通用人工智能的未来演进趋势
综上所述,探讨GPT-4 中有多少个神经元,其核心价值在于让我们看清了数字世界的拟合智能与生物世界的有机智能之间的根本不同。在进行GPT-4参数量与人脑对比时,我们可以清晰地发现,尽管大语言模型的参数规模和计算算力已经达到了惊人的高度,但它在拓扑结构、能量效率和动态自我重构能力上,与人类大脑依然存在巨大的鸿沟。
未来,通用人工智能的实现道路,绝不仅仅是无限制地堆叠大语言模型参数。行业未来的演进趋势,将会越来越多地向生物神经网络学习。通过开发更高效的稀疏激活算法、探索类脑芯片,以及构建能够自我重塑的网络拓扑结构,人工智能终将在维持低功耗的同时,实现逻辑与智慧的下一次跨越式飞跃。